Qué es un AI Engineer
Qué hace el rol, qué habilidades pide y por qué el mismo título cubre cuatro dimensiones que no se parecen entre sí.
El título de AI Engineer se escucha mucho y tiene más miga de la que parece. Si estás contratando uno, o solo quieres entender qué hace, sigue leyendo.
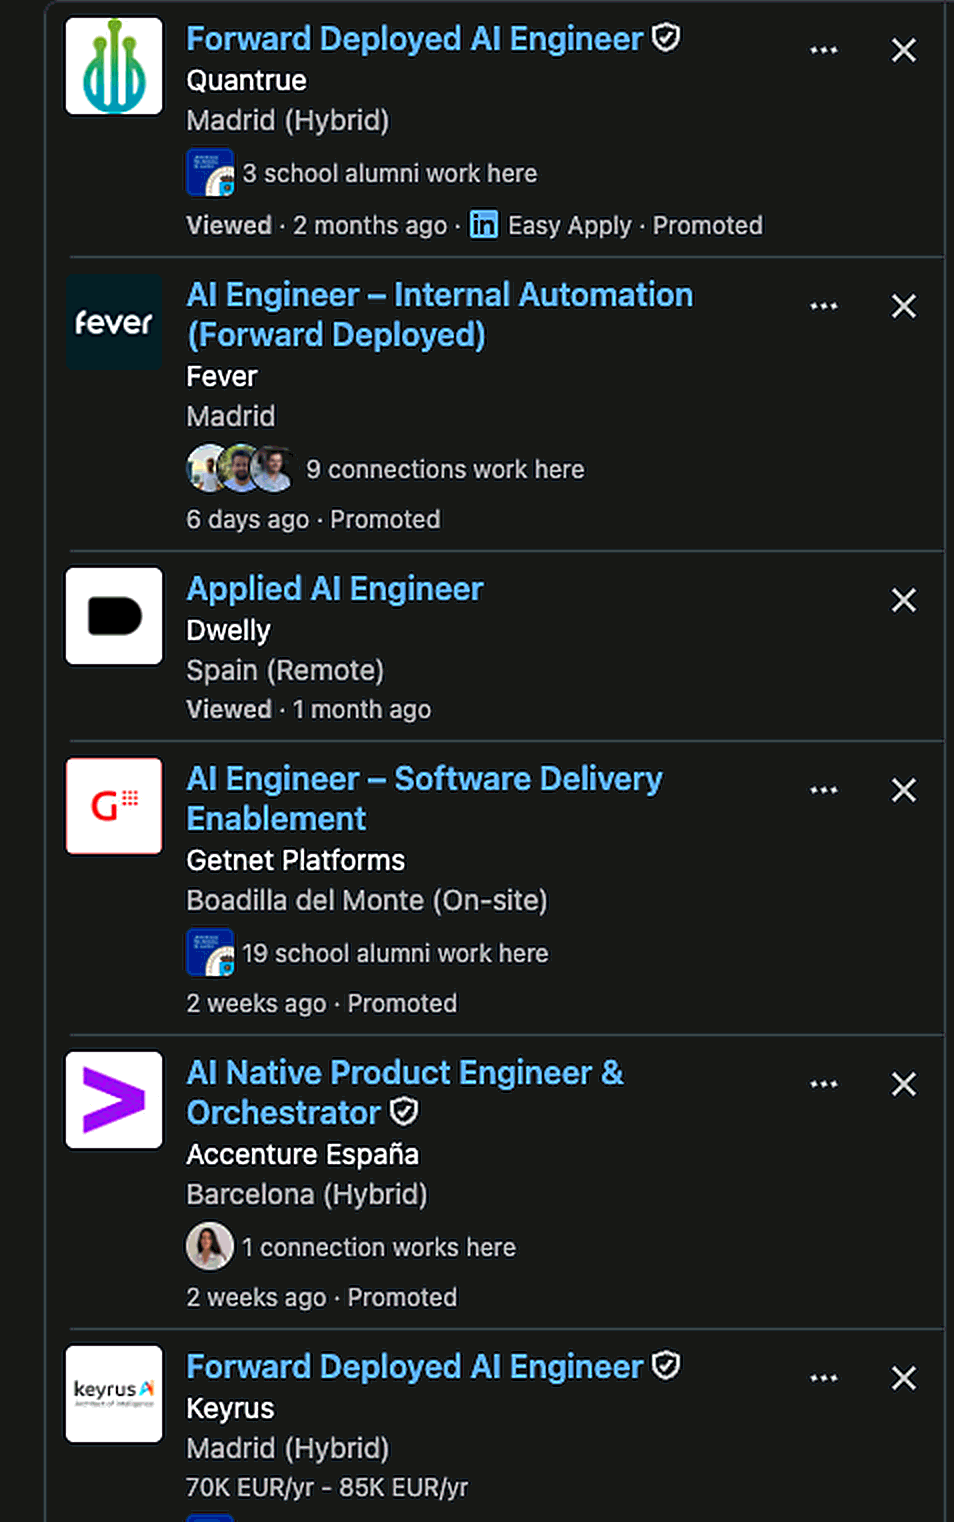
Estas seis estaban abiertas a la vez, todas en España. Uno va desplegado en casa del cliente, otro automatiza procesos internos, otro orquesta agentes de producto. Títulos parecidos para trabajos que no se parecen, así que vamos a indagar un poco.
Como la definición aún se está formando, vamos a apoyarnos en el mapa de habilidades de Andrew Ng y en las casi 7.000 ofertas que lleva recogidas Alexey Grigorev, y los cruzamos con lo que vemos contratando en España.
Esta es la primera de tres piezas sobre AI engineer. Las otras dos se apoyan en datos propios: cuánto cobra un AI Engineer en España y quién ocupa hoy esos puestos.
Qué es un AI Engineer
Un AI Engineer construye y sostiene los sistemas que rodean a un modelo de lenguaje. El caso más común, y el que vas a ver en la mayoría de las ofertas, es este ejemplo de Yarchi: el equipo legal tiene 4.000 contratos y quiere preguntarles cosas en lenguaje normal. Alguien tiene que trocear esos contratos, decidir qué trozos ve el modelo en cada pregunta y medir cuántas respuestas salen mal. Ese es el trabajo.
Andrew Ng prefiere hablar de habilidades de ingeniería de IA antes que del rol de AI Engineer, porque las habilidades son más amplias que el puesto. Su comparación es buena. Hoy cualquier desarrollador debería saber trabajar con la nube, y solo unos pocos tienen “Cloud Engineer” en el título. Con la IA pasa lo mismo. Full-stack, data engineers, DevOps, ML engineers y, sí, también AI engineers, todos van a necesitar habilidades de ingeniería de IA.
Ese matiz se ve en nuestros datos. En la muestra de perfiles técnicos que analizamos en España, 5.980 declaran habilidades de IA generativa, y solo 849 de ellos llevan el título de AI Engineer. El 14,2%. Con el título hay 1.878; lo que dice el 849 es cuántos de esos declaran además la skill. Lo desarrollamos en la tercera pieza de esta serie.
El título cubre cuatro dimensiones
01 Modelo
ML Engineer
Entrena y adapta modelos: etiquetar los datos, hacer fine-tuning y decidir cuándo compensa frente a llamar a un modelo grande. El camino que describen todos los roadmaps y para el que casi nadie contrata.
02 Plataforma
AI Platform Engineer
Las herramientas internas de los que construyen: por dónde pasan las llamadas, cuánto cuestan y qué hacer cuando fallan.
03 Aplicación
LLM Application Engineer
Producto sobre un modelo ajeno. No lo toca. Monta todo lo que lo rodea para que responda con los datos de la empresa: buscar en los documentos y pasarle al modelo solo los trozos que hacen falta.
04 Negocio
Forward-Deployed / AI Product Engineer
Dentro del negocio del cliente. Entender el proceso pesa tanto como escribir el código.
Atraviesa los cuatro. Es medir cada cuánto responde mal, sobre un conjunto fijo de casos. La nombra entre la mitad y siete de cada diez ofertas del rol en España, según dónde pongas el límite de qué cuenta como evaluación.
Cuál necesitas, con los ejemplos de Yarchi. Si el problema es que el modelo no sabe nada de tu negocio, quieres el 03. Si es que tres equipos llaman a cuatro proveedores y nadie sabe cuánto cuesta, el 02. Si lo que hay que automatizar es un proceso de negocio y entenderlo pesa tanto como programarlo, el 04. El 01 es el más raro de los cuatro, y si de verdad necesitas a alguien que toque los pesos del modelo, cuenta con tardar: solo el 2,9% de los perfiles con este título en España declara fine-tuning.
Esta taxonomía sale de la síntesis que hizo Yarchi sobre el corte de 4.894 descripciones que tenía entonces el dataset de Alexey Grigorev, recogidas en Estados Unidos, Europa e India. No todas llevan AI Engineer en el título: el corpus incluye también plataforma y datos. Es el único conjunto de datos público que conocemos sobre esta pregunta.
Chip Huyen separa la ingeniería de IA del ML por dos cosas: adaptar modelos y evaluarlos, en vez de construirlos. Y parte la adaptación en dos vías según se toquen o no los pesos: prompting a un lado, fine-tuning al otro. En España la segunda apenas aparece. De los más de 1.800 perfiles que llevan el título o una variante, solo el 2,9% dice saber hacer fine-tuning: reentrenar el modelo con tus datos, en vez de solo darle instrucciones. El rol que se ocupa aquí vive en la capa de aplicación. Si el post-training se abarata de verdad, ese 2,9% subirá rápido y habrá que volver a medirlo. Cuando lo medimos en agosto salía un 0,8%, con un diccionario de skills que solo miraba etiquetas en inglés; al contarlas también en castellano sube al 2,9%.
Para contratar esto importa más de lo que parece. El que entrena modelos y el que te monta un sistema en producción contra tus datos no son la misma persona, y no cuesta lo mismo encontrarlos. Si pides el perfil equivocado, lo vas a pagar en meses de búsqueda. El 3% lo sacamos de la tercera pieza, contando qué skills declara cada perfil.
Qué habilidades hacen falta, según Andrew Ng
Arriba partimos el título en cuatro trabajos. Esto es otra cosa: las habilidades que te van a pedir en cualquiera de los cuatro.
El mapa de habilidades de Andrew Ng está construido sobre más de 10.000 ofertas de empleo, decenas de entrevistas con expertos, hiring managers y recruiters, y encuestas.
Tiene cuatro habilidades de primer nivel:
- Construir y desplegar aplicaciones de IA.
- Fundamentos de ingeniería de software. Saber qué tradeoffs existen entre coste, escalabilidad, fiabilidad y velocidad. Andrew Ng lo contrapone a quien hace vibe coding sin saber qué decisiones está tomando por él su agente, que suelen ser malas porque no sabe qué contexto darle.
- Programar con agentes. Tener un buen modelo mental de cómo funcionan, conocer sus límites y saber cuánto intervenir y cuánto dejarlos solos.
- Dar forma al trabajo. Como los agentes cumplen cada vez mejor una especificación clara, el trabajo del ingeniero se desplaza a decidir qué va en esa especificación. Eso pide criterio de producto y entender el negocio y al cliente.
De las cuatro, en este artículo desarrollamos la primera. La segunda y la cuarta se las pedirías a cualquier ingeniero senior, con IA o sin ella. La tercera es muy importante, y quizá la desarrollemos en otro momento. La primera es la única que solo tiene sentido cuando hay un modelo dentro del producto, y es la que decide a quién contratas.
En otro artículo, Andrew Ng entra en el detalle de esa primera habilidad y la parte en seis piezas:
Habilidades de ingeniería de IA · según Andrew Ng
-
Construir y desplegar aplicaciones de IA
-
Fundamentos de ingeniería de software — Saber qué tradeoffs existen
-
Programar con agentes — Cuándo intervenir y cuándo no
-
Dar forma al trabajo — Decidir qué entra en la especificación
La premisa de Andrew Ng es que el software con IA tiene una salida menos predecible que el software normal. No sabes de antemano qué va a responder un LLM. Por eso construirlo es mucho más iterativo. Escribes un trozo, lo examinas y decides qué probar después, y esa secuencia depende de lo que vayas encontrando. Lo resume así: saber decidir bien el siguiente paso es lo que te permite construir sistemas fiables a partir de componentes de IA que no lo son.
Las seis piezas de construir y desplegar aplicaciones de IA
Qué decide un AI Engineer dentro de cada una.
Fundamentos de LLM
Entender cómo tokeniza y cómo genera outputs un LLM te dice cuándo puedes confiar en el modelo y cuándo va a fallar.
- Qué meter en la ventana de contexto
- Cuándo usar multimodal
- Aciertos de caché y fecha de corte del conocimiento
- Nivel de esfuerzo de razonamiento y parámetros de sampling
- Cuándo usar tool calling
- Cuándo hace falta fine-tuning o self-hosting
Anclar el modelo en datos
Un LLM sin buen contexto no sirve. RAG con búsqueda vectorial fue el primer intento, pero hoy hay más formas de darle ese contexto.
- Qué va en el prompt y qué recupera el modelo por su cuenta
- Índice vectorial, grafo de conocimiento o capa semántica sobre datos estructurados
- Convertir texto, PDF, HTML e imágenes en algo que el modelo pueda leer
- Mantener esos pipelines limpios y al día
Construir sistemas agénticos
Van desde un workflow con una secuencia fija de llamadas hasta un harness donde el modelo decide su siguiente paso.
- Qué encadenas, qué paralelizas, qué resuelves con código y qué con LLM
- Qué herramientas puede llamar: MCP, CLI, sandbox
- Qué memoria y cómo gestionas el contexto en sesiones largas
- Si hace falta orquestar varios agentes
- El salto a producción: guardarraíles, entradas adversarias, exfiltración, gobernanza
Desarrollo dirigido por evaluación
Para Andrew Ng es el rasgo que más distingue a alguien bueno construyendo estos sistemas: saber llevar un bucle disciplinado de evals y análisis de errores. Cuesta dominarlo porque el enfoque correcto cambia según el proyecto y hasta según la fase.
- Mirar trazas y hacer análisis exploratorio
- Decidir qué medir, cruzándolo con criterio de producto y de negocio
- Cuándo evaluar por código, cuándo con LLM-as-a-judge y cuándo con una persona
Operar en producción
Distinto del software clásico por la impredecibilidad, el coste y la latencia.
- Observabilidad sobre uso real y detección de drift
- Respuesta a fallos del modelo y a inyecciones de prompt
- Testing de regresión y CI/CD con evaluación estadística, calibrada al riesgo del error
- Bajar coste y latencia: elección de modelo, destilación, fine-tuning, simplificar el workflow
Fundamentos de machine learning
Los marcos mentales para decidir cuando la salida del sistema es incierta, y saber usar machine learning: un modelo que haya entrenado otro o uno que entrenes tú.
- Sesgo y varianza
- Análisis de errores
- Ingeniería de los datos
Si estás entrevistando, pregunta por la cuarta, el desarrollo dirigido por evaluación: cuando tu sistema empezó a fallar, ¿cómo lo mediste, sobre cuántos casos y qué cambió el número? Quien ha hecho ese trabajo contesta con números concretos.
Qué medimos en las dos piezas siguientes
Las dos piezas siguientes lo medimos con datos nuestros. En la de salarios nos salió una brecha de 19.600 € por el mismo título, según quién publique la oferta. Y en la de perfiles, el número que no esperábamos: 43 personas de 1.878 buscando trabajo.
Datos y metodología
Los datos propios que aparecen aquí están medidos y explicados en las otras dos piezas: los que salen de perfiles (el pool de IA generativa y el 2,9% de fine-tuning) en la tercera, y los que salen de ofertas (las 476, los 19.600 € y cuántas nombran la evaluación) en la segunda. Lo demás es ajeno y lo citamos tal cual:
- La definición por adaptación de modelos es de Chip Huyen, en The AI Engineering Stack y en su libro AI Engineering (O’Reilly, 2025). Las dos vías que describe son prompting y fine-tuning, según actualicen o no los pesos.
- El mapa de habilidades es de Andrew Ng y no lo hemos verificado. Sale de más de 10.000 ofertas, entrevistas y encuestas. El mapa completo y la parte que resumimos.
- La taxonomía de los cuatro trabajos viene de la síntesis que hizo Yarchi sobre el dataset de Alexey Grigorev: 4.894 descripciones de builtin.com en Los Ángeles, Nueva York, Londres, Ámsterdam, Berlín e India, entre febrero y junio de 2026. Ese es el corte sobre el que se construyó la taxonomía; el dataset ha seguido creciendo y hoy va por 6.964 descripciones hasta agosto, que es la versión que usamos en la pieza de salarios. No coincidimos ni en muestra ni en método: la suya es builtin.com en seis mercados con las skills extraídas por un modelo, la nuestra LinkedIn España contando palabras. Yarchi avisa de que los recuentos por palabra clave marcan dirección, no decimales, y Grigorev dice de los suyos que son menos precisos que un análisis estadístico estricto pero representativos. Nuestra lectura del dataset.
Este artículo se actualiza. Cuando haya datos nuevos se reescribe en esta misma URL, en vez de publicarse otra vez.